目录
关于FileInputStream、FileOutputStream与RandomAccessFile的选择
如何传输大型文件
看了第一章的小伙伴们其实已经知道基础的文件读写功能该如何写了,无非就是读取文件数据流再进行传输。还没明白的小伙伴请移步去另一篇文章学习 http://t.csdn.cn/yuIH1
但如果需要传输大型文件呢?我们应该如何传输?
在传输大型文件时,我们可能会遇到以下问题:
-
内存不足:如果一次性将整个文件读入内存,当文件很大时,可能会导致内存不足的问题。
-
网络传输速度慢:如果文件较大,传输时间会很长,可能会导致网络超时或者传输失败。
-
服务器设置限制:有些服务器可能会限制上传或下载文件的大小,这可能会导致无法传输大型文件。
因此,我们不能一口气将大文件传输到服务器上。但是我们可以将大文件分成若干个小文件再进行传输。
在传输过程中,可能会出现网络中断、传输错误等问题,导致接收方接收到的块顺序不正确或者块数据不完整。为了解决这些问题,最好使用RandomAccessFile 类 。
前置知识
MD5是什么
MD5是一种常用的哈希算法,可以将任意长度的数据“压缩”为一个128位(16字节)的哈希值(hash value),通常用于数据完整性验证、密码验证等方面。在计算文件的MD5时,会通过对文件的所有字节进行哈希计算,得出唯一的MD5值,可以用于校验文件的完整性。
MD5是不可逆的,即无法从MD5值反推出原始数据,这也保证了其在安全领域中的重要性。
对比两个文件的md5值可以用来验证两个文件是否相同。如果两个文件的md5值相同,则可以认为它们的内容是相同的。这种比较通常用于文件传输或备份时,确保传输或备份的文件与原始文件内容一致。在文件校验时,如果两个文件的md5值不同,则说明它们的内容不同,可能是由于文件传输过程中出错或者备份失败导致的。因此,对比两个文件的md5值可以确保文件传输或备份的完整性和正确性。
RandomAccessFile详解
RandomAccessFile是Java中对文件进行随机读写操作的类,相比其他文件类,它有以下优点和缺点。
优点:
- 支持对文件的随机访问,可以读取和修改文件的任意位置,而不必从头开始读取整个文件,提高了读写效率。
- 支持对文件进行读写操作,可以读取和写入各种类型的数据,如整数、浮点数、字符、字符串等。
- 可以通过设置文件指针来实现对文件的截取和插入操作,比如在文件的中间插入新的内容,或者截取文件的一部分进行操作。
缺点:
- 无法直接操作字符流,需要使用字节流来读取和写入数据,使用时需要注意字符编码的转换。
- 无法使用缓存机制来提高读写效率,需要自行实现缓存功能。
- 不支持多线程访问同一文件,需要手动进行同步处理,否则可能会出现文件内容不一致的情况。
- 不支持对文件进行任意长度的扩展或缩小,只能通过修改已有内容或在文件末尾追加内容来实现对文件的修改。
看过前一章的小伙伴肯定会疑问,FileInputStream、FileOutputStream同样能对二进制文件、文本文件、图片、音视频等资源进行操作,为什么建议使用RandomAccessFile呢?
关于FileInputStream、FileOutputStream与RandomAccessFile的选择
先来讲讲它们的区别:
-
FileInputStream和FileOutputStream:这两个类是Java IO库中最基本的文件读写操作类。FileInputStream用于从文件中读取数据,而FileOutputStream用于将数据写入文件中。它们都是一次只能读取或写入一个字节或一个字节数组,因此不能用于读写大文件。而且,它们不能在文件中查找指定的位置。
-
RandomAccessFile:RandomAccessFile也是Java IO库中的一个类,它提供了在文件中任意位置读写数据的功能。与FileInputStream和FileOutputStream不同的是,RandomAccessFile可以指定文件中的任意位置进行读写,并且支持对文件的随机访问,即可以向前或向后读写文件。因此,它适合于读写大文件或需要随机访问文件的情况。
因此,如果需要对小文件进行读写操作,可以使用FileInputStream和FileOutputStream,而如果需要对大文件进行读写操作或需要随机访问文件,则应该使用RandomAccessFile。
环境配置
因为计算文件的Md5值需要使用到DigestUtils工具类,所以需要在pom. xml文件 中导入以下依赖
- <!--DigestUtils工具包的依赖-->
- <dependency>
- <groupId>commons-codec</groupId>
- <artifactId>commons-codec</artifactId>
- <version>1.15</version>
- </dependency>
单机环境下模拟分块传输文件操作
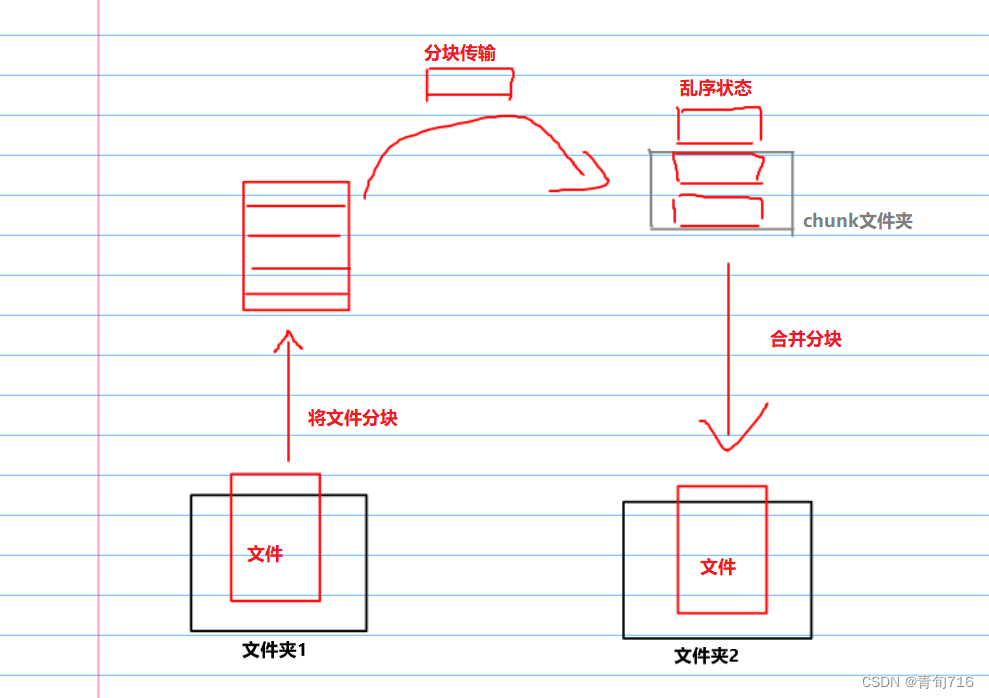
原理图
大致过程
在上传分块文件过程中,我们需要将分块文件暂存在chunk文件夹中,所以得临时创建一个chunk文件夹,上传完毕之后便会将chunk里的所有分块文件合并成一个文件。检测完文件完整性之后便会将chunk文件夹删除。
验证文件完整性需要先计算好原文件的Md5值再与新文件的Md5值来对比判断。有的小伙伴会提问:“为什么需要用原文件来计算Md5值,我直接用流来计算好不就可以了吗?” 因为文件在传输过程中可能会出现失真、丢包等现象,文件流有可能会与原文件不一致。
文件存放路径为 文件的Md5值的第一位+Md5值的第二位+Md5值,例如:"C:\Users\uploadfile\9\8\9856ac885f252fd8839167dec95e484b"。这可以提高程序搜索文件的效率,这种优化方式其实类似HashMap的散列表。
这里将 文件分块+上传分块 和 排序、合并分块+校验文件完整性 功能分为两部分代码
-
void chunkFile(File file, String sourcefileMd5) throws IOException; 根据文件的Md5值(sourcefileMd5)在指定路径下创建chunk文件夹,将文件(file)分块保存至chunk文件夹中。
- void mergeFile(String fileName, String sourceFileMd5) throws IOException; 根据文件的Md5值(sourcefileMd5)将指定路径下的分块文件合并至上一级目录中,再用原文件名(fileName)为新文件命名。
完整代码
- import org.apache.commons.codec.digest.DigestUtils;
-
- import java.io.File;
- import java.io.FileInputStream;
- import java.io.IOException;
- import java.io.RandomAccessFile;
- import java.util.Arrays;
- import java.util.Collections;
- import java.util.Comparator;
- import java.util.List;
-
- public class FileUtils {
-
- /**
- * 文件分块传输
- * @param file 文件
- * @param sourceFileMd5 原文件的Md5值
- */
- public static void uploadBigFile(File file, String sourceFileMd5) {
- try {
- // 将文件分块传输
- chunkFile(file, sourceFileMd5);
- // 合并分块文件
- mergeFile(file.getName(), sourceFileMd5);
- } catch (IOException e) {
- e.printStackTrace();
- }
- }
-
- /**
- * 将文件分块传输
- * @param file 文件
- * @param sourcefileMd5 原文件的Md5值
- * @throws IOException
- */
- private static void chunkFile(File file, String sourcefileMd5) throws IOException {
- File sourceFile = file;
- String chunkFilePath = getChunkFilePath(sourcefileMd5);
- // 判断chunk文件夹是否存在,不存在则创建
- File chunkFolder = new File(chunkFilePath);
- if (!chunkFolder.exists()) {
- chunkFolder.mkdirs();
- }
- // 分块大小
- int chunkSize = 1024 * 1024 * 5;
- // 分块数量
- int chunkNum = (int) Math.ceil(sourceFile.length()*1.0 / chunkSize);
- // 使用RandomAccessFile访问文件
- RandomAccessFile raf_r = new RandomAccessFile(sourceFile, "r");
- // 缓存区大小
- byte[] bytes = new byte[1024];
- for (int i = 0; i < chunkNum; i++) {
- // 创建分块文件
- File chunkFile = new File(chunkFilePath + i);
- if(chunkFile.exists()){
- chunkFile.delete();
- }
- chunkFile.createNewFile();
- RandomAccessFile raf_rw = new RandomAccessFile(chunkFile, "rw");
- int len = -1;
- while((len = raf_r.read(bytes)) != -1) {
- // 每次从缓存区中取出数据存入文件中
- raf_rw.write(bytes, 0, len);
- if(chunkFile.length() >= chunkSize) {
- break;
- }
- }
- raf_rw.close();
- }
- raf_r.close();
- }
-
- /**
- * 文件合并
- * @param fileName 文件名称
- * @param sourceFileMd5 原文件的Md5值
- * @throws IOException
- */
- private static void mergeFile(String fileName, String sourceFileMd5) throws IOException {
- // 分块文件目录
- File chunkFolder = new File(getChunkFilePath(sourceFileMd5));
- // 合并文件
- File mergeFile = new File(getFilePath(sourceFileMd5) + fileName);
- if (mergeFile.exists()) {
- mergeFile.delete();
- }
- // 创建新的合并文件
- mergeFile.createNewFile();
- // 用于写文件
- RandomAccessFile raf_write = new RandomAccessFile(mergeFile, "rw");
- // 指针指向文件顶端
- raf_write.seek(0);
- // 缓冲区
- byte[] b = new byte[1024];
- // 分块列表
- File[] fileArray = chunkFolder.listFiles();
- // 转成集合,便于排序
- List<File> fileList = Arrays.asList(fileArray);
- // 从小到大排序
- Collections.sort(fileList, new Comparator<File>() {
- @Override
- public int compare(File o1, File o2) {
- return Integer.parseInt(o1.getName()) - Integer.parseInt(o2.getName());
- }
- });
- // 合并文件
- for (File chunkFile : fileList) {
- RandomAccessFile raf_read = new RandomAccessFile(chunkFile, "rw");
- int len = -1;
- while ((len = raf_read.read(b)) != -1) {
- raf_write.write(b, 0, len);
-
- }
- raf_read.close();
- }
- raf_write.close();
- // 校验文件
- try (FileInputStream mergeFileStream = new FileInputStream(mergeFile)) {
- // 取出合并文件的md5进行比较
- String mergeFileMd5 = DigestUtils.md5Hex(mergeFileStream);
- if (sourceFileMd5.equals(mergeFileMd5)) {
- System.out.println("合并文件成功");
- // 删除chunk文件夹
- deleteChunkFile(sourceFileMd5);
- } else {
- System.out.println("合并文件失败");
- }
- }
- }
-
- /**
- * 删除chunk文件
- * @param fileMd5 原文件的Md5值
- */
- private static void deleteChunkFile(String fileMd5) {
- String chunkFilePath = getChunkFilePath(fileMd5);
- File directory = new File(chunkFilePath);
- if (directory.isDirectory()) {
- File[] files = directory.listFiles();
- // 遍历删除chunk里所有的分块文件
- for(File file : files) {
- file.delete();
- }
- }
- // 删除chunk文件夹
- directory.delete();
- }
-
- /**
- * 根据Md5计算文件存放路径
- * @param fileMd5 文件的Md5值
- * @return 文件存放路径,例如: "C:\Users\uploadfile\9\8\9856ac885f252fd8839167dec95e484b\"
- */
- private static String getFilePath(String fileMd5) {
- return "C:\\Users\\uploadfile\\" + fileMd5.substring(0, 1) + "\\" + fileMd5.substring(1, 2) + "\\" + fileMd5 + "\\";
- }
-
- /**
- * 根据Md5计算分块文件存放路径
- * @param fileMd5 文件的Md5值
- * @return 文件存放路径,例如: "C:\Users\uploadfile\9\8\9856ac885f252fd8839167dec95e484b\chunk\"
- */
- private static String getChunkFilePath(String fileMd5) {
- return getFilePath(fileMd5) + "chunk\\";
- }
- }

在 Web程序 下传输大型文件
在这种环境下传输大文件的过程跟单机情况有一些区别。因为用户不可能自己编写代码计算文件的Md5值再将文件分块好给后端传输数据,所以这些活都得让前端人干。因此后端需要编写三个接口。
-
boolean checkChunk(String fileMd5, Integer fileId) ; 根据文件的Md5值(fileMd5)和分块文件的编号(fileId)来检查服务器是否存在这个编号的分块文件。
-
boolean uploadFile(MultipartFile multipartFile, String fileMd5, Integer fileId); 根据文件的Md5值(fileMd5)和分块文件的编号(fileId)来找到文件存放路径,然后将分块文件(multipartFile)保存到路径中。
-
boolean mergeFile(String fileName, String sourceFileMd5) throws IOException; 根据原文件名称(fileName)为合并后的新文件命名,然后将前端计算好的原文件的Md5值(sourceFileMd5)与保存好的新文件的Md5值对比判断文件完整性。
断点 续传的原理
- 前端计算好完整文件的Md5值,并将文件分块。
- 前端使用多线程一块一块上传,在这之前先调用checkChunk接口判断该分块是否存在,如果存在则不上传;如果不存在,调用uploadFile接口上传分块。
- 当所有分块文件上传完毕,则调用mergeFile接口通知服务器合并所有分块文件。
- 合并完成之后服务器将前端计算好的Md5值与服务器合并后的文件的Md5值对比来判断文件完整性。
完整代码
- import com.example.spingboottestprogram.service.FileService;
- import org.apache.commons.codec.digest.DigestUtils;
- import org.springframework.stereotype.Service;
- import org.springframework.web.multipart.MultipartFile;
-
- import java.io.File;
- import java.io.FileInputStream;
- import java.io.IOException;
- import java.io.RandomAccessFile;
- import java.util.Arrays;
- import java.util.Collections;
- import java.util.Comparator;
- import java.util.List;
-
- @Service("fileService")
- public class FileServiceImpl implements FileService {
-
- /**
- * 检查分块文件是否存在
- * @param fileMd5 文件Md5值
- * @param fileId 分块文件编号
- * @return 块文件是否存在
- */
- public boolean checkChunk(String fileMd5, Integer fileId) {
- //定义分块文件存放路径
- String chunkFilePath = getChunkFilePath(fileMd5);
- //新建一个目录(文件夹)
- File dest = new File(chunkFilePath + fileId);
- // 判断文件是否存在
- if (!dest.exists()){
- // 不存在返回false
- return false;
- }
- // 存在则返回true
- return true;
- }
-
- /**
- * 下载分块文件
- * @param multipartFile 分块文件
- * @param fileMd5 文件Md5值
- * @param fileId 分块文件编号
- * @return 下载是否成功
- */
- public boolean uploadFile(MultipartFile multipartFile, String fileMd5, Integer fileId) {
- //判断文件是否为空 isEmpty
- if (multipartFile == null || multipartFile.isEmpty()){
- return false;
- }
- //定义分块文件存放路径
- String chunkFilePath = getChunkFilePath(fileMd5);
- //新建一个目录(文件夹)
- File dest = new File(chunkFilePath + fileId);
- if (!dest.getParentFile().canExecute()){
- dest.getParentFile().mkdirs();
- }
- try {
- //文件输出
- multipartFile.transferTo(dest);
- }
- catch (Exception e) {
- e.printStackTrace();
- //拷贝失败要有提示
- return false;
- }
- return true;
- }
-
- /**
- * 合并分块
- * @param fileName 新文件名字
- * @param sourceFileMd5 前端计算好的原文件的Md5值
- * @return 合并是否成功
- * @throws IOException
- */
- public boolean mergeFile(String fileName, String sourceFileMd5) throws IOException {
- // 分块文件目录
- File chunkFolder = new File(getChunkFilePath(sourceFileMd5));
- // 合并文件
- File mergeFile = new File(getFilePath(sourceFileMd5) + fileName);
- if (mergeFile.exists()) {
- mergeFile.delete();
- }
- // 创建新的合并文件
- mergeFile.createNewFile();
- // 用于写文件
- RandomAccessFile raf_write = new RandomAccessFile(mergeFile, "rw");
- // 指针指向文件顶端
- raf_write.seek(0);
- // 缓冲区
- byte[] b = new byte[1024];
- // 分块列表
- File[] fileArray = chunkFolder.listFiles();
- // 转成集合,便于排序
- List<File> fileList = Arrays.asList(fileArray);
- // 从小到大排序
- Collections.sort(fileList, new Comparator<File>() {
- @Override
- public int compare(File o1, File o2) {
- return Integer.parseInt(o1.getName()) - Integer.parseInt(o2.getName());
- }
- });
- // 合并文件
- for (File chunkFile : fileList) {
- RandomAccessFile raf_read = new RandomAccessFile(chunkFile, "rw");
- int len = -1;
- while ((len = raf_read.read(b)) != -1) {
- raf_write.write(b, 0, len);
-
- }
- raf_read.close();
- }
- raf_write.close();
- // 校验文件
- try (FileInputStream mergeFileStream = new FileInputStream(mergeFile)) {
- // 取出合并文件的md5进行比较
- String mergeFileMd5 = DigestUtils.md5Hex(mergeFileStream);
- if (sourceFileMd5.equals(mergeFileMd5)) {
- System.out.println("合并文件成功");
- deleteChunk(sourceFileMd5);
- return true;
- } else {
- System.out.println("合并文件失败");
- return false;
- }
- }
- }
-
- /**
- * 删除桶
- */
- private void deleteChunk(String fileMd5) {
- String chunkFilePath = getChunkFilePath(fileMd5);
- File directory = new File(chunkFilePath);
- if (directory.isDirectory()) {
- File[] files = directory.listFiles();
- // 遍历删除chunk里所有的分块文件
- for(File file : files) {
- file.delete();
- }
- }
- // 删除chunk文件夹
- directory.delete();
- }
-
- /**
- * 根据Md5计算文件存放路径
- * @param fileMd5 文件的Md5值
- * @return 文件存放路径,例如: "C:\Users\uploadfile\9\8\9856ac885f252fd8839167dec95e484b\"
- */
- private static String getFilePath(String fileMd5) {
- return "C:\\Users\\uploadfile\\" + fileMd5.substring(0, 1) + "\\" + fileMd5.substring(1, 2) + "\\" + fileMd5 + "\\";
- }
-
- /**
- * 根据Md5计算分块文件存放路径
- * @param fileMd5 文件的Md5值
- * @return 文件存放路径,例如: "C:\Users\uploadfile\9\8\9856ac885f252fd8839167dec95e484b\chunk\"
- */
- private static String getChunkFilePath(String fileMd5) {
- return getFilePath(fileMd5) + "chunk\\";
- }
- }
看到这里,小伙伴们其实就已经发现这串代码跟上面的代码的实现原理差不多。
如果想深入了解代码的实现可以前往 Git仓库 克隆代码学习 GitHub - QingXun123/fileio-2
Java文件读写(一)基础文件读写的详细操作:http://t.csdn.cn/yuIH1
Java文件读写(二)网络传输大型文件的原理:http://t.csdn.cn/xyJpo (所在位置)
后面我会持续更新有关文件读写的文章。
关注作者,获取更多精彩内容!